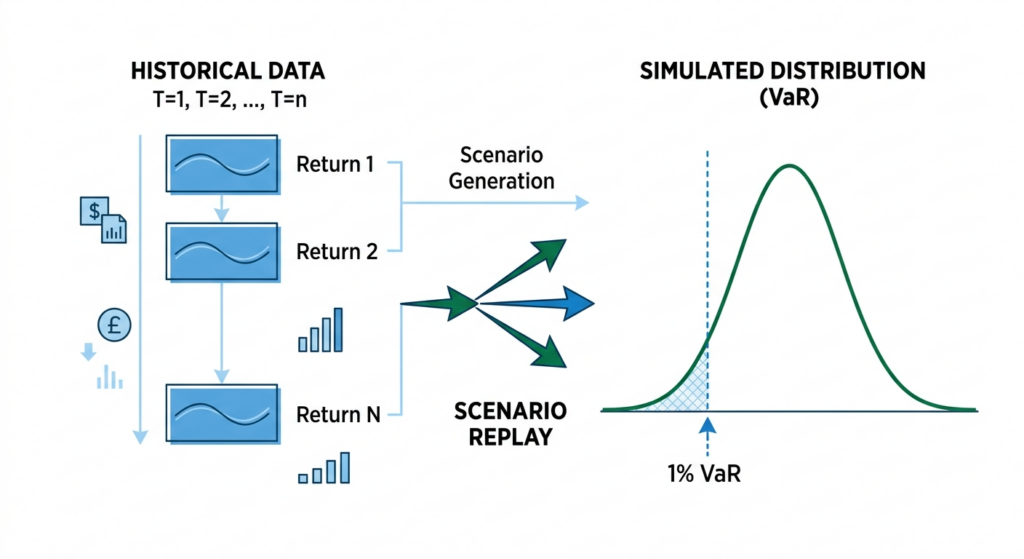
1. 역사적 시뮬레이션(Historical Simulation) 방법이란?
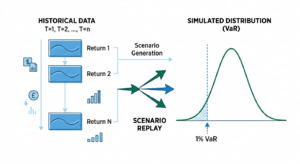
분산-공분산 방법이 “수익률이 정규분포(Normal Distribution)를 따른다”는 가정(Assumption)을 바탕으로 통계적 방법(표준편차, Z-스코어 등)을 통해 VaR를 산출하는 방식이라면, 역사적 시뮬레이션은 “과거에 일어났던 일 하루 가격 변동이 다시 현재 발생한다면”라는 전제 하에 과거의 실제 시장 가격 변동 데이터를 그대로 “현재 포트폴리오”에 대입해 보는 비모수적(Non-parametric) 방식입니다.
즉, 분포의 형태를 가정하지 않고 과거 1년(예: 250거래일) 동안 실제로 발생했던 수익률 데이터를 나열한 뒤, 가장 손실이 컸던 순서대로 줄을 세워 VaR를 측정합니다.
2. 계산 방법
-
- 과거 데이터 수집: 포트폴리오에 포함된 모든 자산(채권, 주식, 환율 등)의 과거 일정 기간(예: 최근 1년 또는 2년, 총 \(N\)거래일) 동안의 실제 일간 가격 변동률(또는 수익률) 시계열을 수집합니다.
- 현재 포트폴리오에 역사적 충격(Scenario) 적용: 현재 보유하고 있는 포트폴리오 구성 그대로, 과거 \(N\)일 동안 매일 발생했던 시장 변동을 하나씩 대입하여 가상의 일간 손익(P&L) \(N\)개를 시뮬레이션합니다.
(여기서 \(V_0\)는 현재 포트폴리오 가치, \(R_{port, t}\)는 과거 \(t\) 시점의 포트폴리오 수익률)
- 손실 분포 정렬 (Sort): 산출된 \(N\)개의 일간 손익을 수익이 큰 순서부터 손실이 큰 순서(오름차순)로 정렬합니다.
- VaR 도출: 만약 최근 250거래일(약 1년)의 데이터가 있고, 99% 신뢰수준의 VaR를 구한다면, 전체 250개 손실 중 하위 1%에 해당하는 3번째(250 \(\times\) 0.01)로 큰 손실 금액이 바로 1일 VaR가 됩니다.
3. 분산-공분산 법과의 차이점
| 구분 | 분산-공분산 법 (Variance-Covariance) | 역사적 시뮬레이션 (Historical Simulation) |
| 분포 가정 | 정규분포 가정 (선형성 중심) | 과거 데이터 그대로 적용 (특정한 분포를 가정하지 않고, 과거 데이터가 곧 분포) |
| Fat-Tail 문제 | 반영 불가 (극단적 충격 과소평가 위험) | 자동 반영 (과거에 금융위기 등이 포함되어 있다면 그대로 반영됨) |
| 비선형 상품(옵션 등) 대응 | 취약함(델타 근사 필요) | 우수함 (가격 계산 엔진만 있으면 옵션/구조화 상품도 완벽 대응) |
| 한계점 | 현실 시장의 급등락(비정규성)을 놓칠 수 있음 | 과거의 기억에 의존함 (과거에 없던 새로운 충격이나 블랙스완, 시장 변화는 예측 불가) |
4. 채권 포트폴리오 관점에서의 의미
앞서 다루었던 원금매핑이나 듀레이션 매핑, 현금흐름 매핑이 주로 분산-공분산 법에서 공분산 행렬의 차원을 줄이고 계산을 효율화하기 위해 사용되었다면, 역사적 시뮬레이션은 이러한 복잡한 과정없이, 과거 특정 시점의 금리 변동 상황을 그대로 재 계산하여 포트폴리오의 손실을 계산하면 되므로 개념적으로는 이해하기 쉬운 장점이 있습니다.
- 가격 계산 엔진(Pricing Engine)과의 결합: 만약 정교한 채권/파생상품 가격 계산 엔진이 있다면, 과거 250일 동안의 금리 곡선(Yield Curve) 변화 자체를 포트폴리오에 그대로 적용하여 매일의 가격 변화를 정확히 재현할 수 있습니다.
- 따라서 매핑 과정에서 발생하는 모델 오차(Model Error)를 줄일 수 있지만, 반대로 연산량이 방대해진다는 특징이 있습니다.
- 파생상품이나 주식 등과 결합한 상품인 경우 ( ELS, 이자율 파생상품 등 ) 한 종목의 1일 계산 시간이 몇 분씩 걸릴 수도 있습니다.