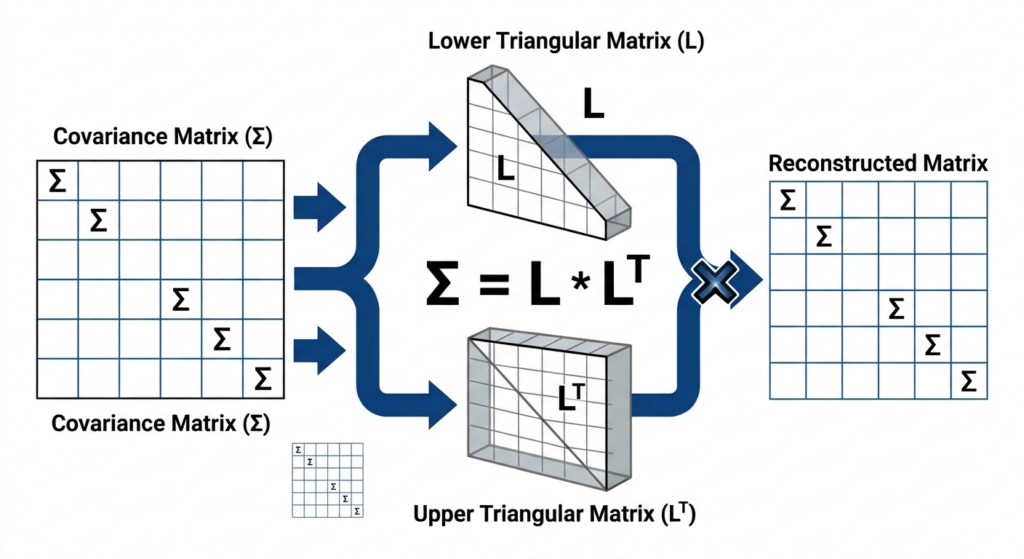
1. 촐레스키 분해( Cholesky Decomposition )
독립적인 난수들을 실제 자산들의 상관관계에 맞게 변환(Transformation)해주어야만 의미 있는 포트폴리오 시뮬레이션을 수행할 수 있습니다. 가장 널리 쓰이는 표준적인 방법이 바로 콜레스키 분해(Cholesky Decomposition)입니다.
1.1. 핵심 원리: 콜레스키 분해 (Cholesky Decomposition)
우리가 원하는 것은 평균이 0이고, 정해진 공분산 행렬 \(\Sigma\)를 따르는 다변량 정규분포(Multivariate Normal Distribution) 형태의 난수를 만드는 것입니다.
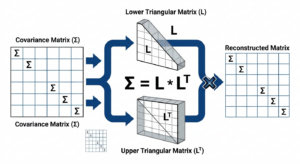
이를 위해 선형대수학의 콜레스키 분해를 이용합니다. 대칭 양정치 행렬(Symmetric Positive Definite Matrix)인 공분산 행렬 \(\Sigma\)는 다음과 같이 하부 삼각 행렬(Lower Triangular Matrix) \(L\)과 그 전치 행렬의 곱으로 쪼갤 수 있습니다.
여기서 \(L\)은 자산 간의 상관구조와 변동성 정보가 녹아들어 있는 ‘필터(가중치 행렬)’ 역할을 합니다. 이 \(L\) 행렬에 독립된 표준정규난수 벡터를 곱해주면, 원하던 상관관계를 가진 난수가 탄생합니다.
1.2. 구체적인 변환 과정 (4단계)
① 목표 공분산(또는 상관) 행렬 정의 (\(\Sigma\))
포트폴리오에 포함된 자산들의 역사적 데이터로부터 공분산 행렬 \(\Sigma\)(또는 상관계수 행렬 \(C\)와 표준정규분포 벡터)를 구합니다.
- 예: 3개 자산이라면 \(3 \times 3\) 크기의 공분산 행렬이 됩니다.
② 콜레스키 분해 수행 (\(L\) 구하기)
공분산 행렬 \(\Sigma\)를 콜레스키 분해하여 하부 삼각 행렬 \(L\)을 구합니다.
\(\Sigma \implies L \quad\) ( 단, \(L\) 은 대각선 위쪽이 모두 0인 하부 삼각 행렬)
③ 독립된 표준정규난수 생성 (\(Z\))
아무런 상관관계가 없는 독립적인 표준정규분포 난수(\(N(0, 1)\)) 벡터 \(Z\)를 생성합니다.
-
- 자산이 \(N\)개라면, \(N \times 1\) 크기의 독립 난수 벡터가 만들어집니다.
\(Z = \begin{bmatrix} z_1 \\ z_2 \\ \vdots \\ z_n \end{bmatrix}, \quad E[Z] = 0, \quad \text{Cov}(Z) = I\) (단위행렬)
④ 선형 결합을 통한 상관관계 부여 (\(X\))
생성한 독립 난수 벡터 \(Z\)에 하부 삼각 행렬 \(L\)을 곱해줍니다. 이 새로운 벡터를 \(X\)라고 합니다.
1.3. 수학적 검증: 왜 상관관계를 가지게 되는가?
이렇게 변환된 \(X\) 벡터의 공분산 행렬을 수학적으로 유도해보면 다음과 같습니다.
\( Cov (X) = E[X X^T] = E[(L Z) (L Z)^T] \)
행렬 연산 규칙에 의해 전치 행렬을 풀면 다음과 같이 정리됩니다.
\( Cov(X) = E[L Z Z^T L^T] = L E[Z Z^T] L^T\)
여기서 \(Z\)는 서로 독립인 표준정규난수이므로, \(Z\)의 공분산 \(E[Z Z^T]\)는 단위행렬(\(I\))이 됩니다.
\( Cov(X) = L I L^T = L L^T = \Sigma\)
결과적으로 변환된 난수 벡터 \(X\)의 공분산 행렬은 우리가 애초에 목표로 했던 원래의 공분산 행렬 \(\Sigma\)와 정확히 일치하게 됩니다. 즉, 컴퓨터가 만든 무작위 숫자들이 채권이나 주식 간의 실제 역사적 상관관계를 완벽히 반영한 숫자로 변환된 것입니다.
만약 자산 간의 다중공선성(Multicollinearity)이 너무 심해서 공분산 행렬이 양정치(Positive Definite) 조건을 만족하지 못할 때(행렬식determinant이 0에 가까울 때)는 콜레스키 분해가 실패할 수 있습니다. 이럴 때는 고유값 분해(Eigenvalue Decomposition / Spectral Decomposition)나 PCA(주성분 분석)를 활용해 준정치 행렬을 보정(Near-PD adjustment)한 뒤 상관관계를 부여하는 방식을 사용합니다.
2. PCA ( Principal Component Analysis )
실제 VaR 계산을 하다 보면 자산 간의 중복성이 높거나(다중공선성), 데이터 오차로 인해 행렬의 행렬식(Determinant)이 0이 되거나 극단적인 경우 음수(-)의 고유값이 발생하여 콜레스키 분해가 깨지게 됩니다. 특히 채권의 경우 서로 유사한 금리 구간들이 너무 유사하게 특정한 위치에 집중적으로 계속 쌓여 있는 경우 더 빈번하게 발생합니다. 이때 PCA를 활용하면 이 문제를 해결하고 안정적으로 상관관계를 부여할 수 있습니다.
2.1. 콜레스키 분해가 실패하는 이유와 PCA의 접근 방식
- 콜레스키의 한계: \(L L^T = \Sigma\)를 만족하는 하부 삼각 행렬 \(L\)을 찾으려면 행렬 내부적으로 제곱근(\(\sqrt{}\)) 연산이 들어가야 하는데, 음수 고유값이 존재하면 실숫값으로 \(L\)을 구할 수 없습니다.
- PCA의 해결책 : 행렬을 대각화하는 고유값 분해를 통해, 음수 고유값을 0에 가까운 양수로 강제 보정(Near-PD Adjustment)하거나 아예 영향력이 없는 미미한 차원을 잘라내어(차원 축소) 수학적으로 완벽한 분해가 가능하도록 만듭니다.
2.2. PCA를 이용한 상관관계 난수 생성 프로세스
① 고유값 분해 (Spectral Decomposition)
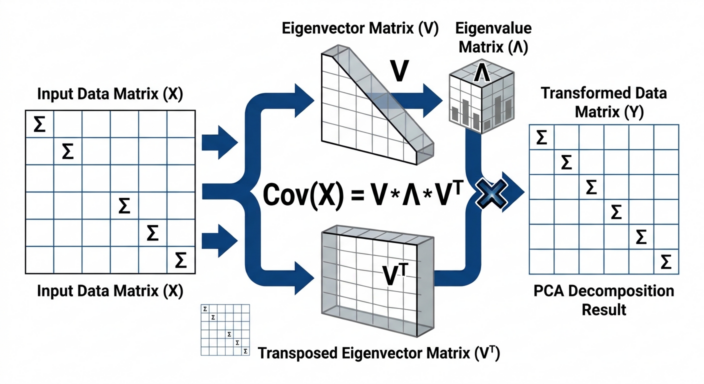
공분산 행렬 \(\Sigma\)를 고유값(Eigenvalue)과 고유벡터(Eigenvector)로 쪼갭니다. 잘 모르는 용어가 나오면 일단 넘어가시기 바랍니다.
\(\Sigma = V \Lambda V^T\)
- \(V\): 고유벡터들로 이루어진 직교 행렬 (각 자산들이 어떤 방향으로 움직이는지 나타내는 축(Factor))
- \(\Lambda\): 고유값들로 이루어진 대각 행렬 (\(\lambda_1, \lambda_2, \dots, \lambda_n\)) (각 축이 가지는 분산의 크기, 즉 중요도)
② 고유값 보정 (Near-PD 정제)
만약 데이터 오차 때문에 \(\Lambda\)에 아주 작은 음수(-0.0001 등)가 섞여 있다면, 이를 0 또는 아주 작은 양수로 치환하여 행렬이 양정치 조건을 만족하도록 정제합니다.
③ 독립 난수 생성 및 스케일링 (\(Z\)와 \(\sqrt{\Lambda}\))
- 아무런 상관관계를 가지지 않는 표준정규난수 벡터 \(Z\) (\(N(0, 1)\))를 생성합니다.
- 고유값 행렬 \(\Lambda\)의 각 성분에 제곱근(\(\sqrt{\lambda}\))을 씌워 표준편차 스케일로 만듭니다.
④ 최종 상관관계 난수 합성 (\(X\))
고유벡터 행렬 \(V\)와 스케일링된 난수를 결합하여, 실제 자산의 공분산 구조를 완벽히 반영한 난수 벡터 \(X\)를 생성합니다.
2.3. 수학적 검증: 왜 원래의 공분산이 복원되는가?
이렇게 만든 난수 벡터 \(X\)의 공분산 행렬을 유도해보면 다음과 같습니다.
\(Cov(X) = E[X X^T] = E[(V \sqrt{\Lambda} Z) (V \sqrt{\Lambda} Z)^T]\)
행렬 연산 규칙에 따라 전치 행렬을 풀면 다음과 같이 정리됩니다.
\(Cov(X) = V \sqrt{\Lambda} E[Z Z^T] (\sqrt{\Lambda})^T V^T\)
여기서 \(Z\)는 독립 표준정규난수이므로 \(E[Z Z^T] = I\) (단위행렬)가 됩니다. 또한 \(\sqrt{\Lambda}\)는 대각 행렬이므로 자기 자신과 전치 행렬이 같습니다.
\(Cov(X) = V \sqrt{\Lambda} I \sqrt{\Lambda} V^T = V (\Lambda) V^T = \Sigma\)
결과적으로 우리가 처음 가졌던 공분산 행렬 \(\Sigma\)가 완벽하게 복원됩니다.
💡 실제 예
예를 들어, 어떤 포트폴리오에 두 자산(자산 A, 자산 B)이 있고, 과거 4개 시점(행) 동안의 일간 수익률 데이터(\(X\)가 다음과 같이 있다고 가정해 봅시다.
\(X = \begin{bmatrix} 1 & 2 \\ 2 & 3 \\ 3 & 3 \\ 4 & 6 \end{bmatrix} \quad ( \)행: 시간 \(t_1 \sim t_4, \) 열: 자산 A, 자산 B \()\)
Step 1: 데이터 중심화 (Mean Centering)
PCA를 시작하기 전, 각 열(자산)의 평균을 구해서 모든 데이터에서 빼주어야 합니다. (평균을 0으로 맞추는 작업)
- 자산 A의 평균: \((1 + 2 + 3 + 4) / 4 = 2.5\)
- 자산 B의 평균: \((2 + 3 + 3 + 6) / 4 = 3.5\)
중심화된 데이터 행렬 \(X_{centered}\)는 다음과 같이 계산됩니다.
\(X_{centered} = \begin{bmatrix} 1 – 2.5 & 2 – 3.5 \\ 2 – 2.5 & 3 – 3.5 \\ 3 – 2.5 & 3 – 3.5 \\ 4 – 2.5 & 6 – 3.5 \end{bmatrix} = \begin{bmatrix} -1.5 & -1.5 \\ -0.5 & -0.5 \\ 0.5 & -0.5 \\ 1.5 & 2.5 \end{bmatrix}\)
Step 2: 공분산 행렬(Covariance Matrix) 구하기
중심화된 데이터로 자산 간의 관계를 보여주는 공분산 행렬 \(C\)를 계산합니다. (공식: \(C = \frac{1}{n-1} X_{centered}^T X_{centered}\))
- 자산 A의 분산: \(\frac{(-1.5)^2 + (-0.5)^2 + (0.5)^2 + (1.5)^2}{4 – 1} = \frac{5}{3} \approx 1.67\)
- 자산 B의 분산: \($\frac{(-1.5)^2 + (-0.5)^2 + (-0.5)^2 + (2.5)^2}{4 – 1} = \frac{8.75}{3} \approx 2.92\)
- A와 B의 공분산: \(\frac{(-1.5)(-1.5) + (-0.5)(-0.5) + (0.5)(-0.5) + (1.5)(2.5)}{4 – 1} = \frac{5.75}{3} \approx 1.92\)
따라서 공분산 행렬 \(C\)는 다음과 같습니다.
\(C = \begin{bmatrix} 1.67 & 1.92 \\ 1.92 & 2.92 \end{bmatrix}\)
Step 3: 고유값 분해 (Eigenvalue Decomposition) – 핵심 연산
이제 공분산 행렬 \(C\)를 고유값(\(\lambda\))과 고유벡터(\(v\))로 쪼갭니다. 이 과정은 다음 방정식을 푸는 것입니다.
\(\det(C – \lambda I) = 0\)
이 행렬을 풀면 두 개의 고유값이 나옵니다. (분산의 크기)
- \(\lambda_1 = 4.38\) (첫 번째 주성분이 설명하는 변동성의 크기)
- \(\lambda_2 = 0.21\) (두 번째 주성분이 설명하는 변동성의 크기)
그리고 각 고유값에 대응하는 고유벡터(Eigenvector, \(v\))를 구합니다. 이 고유벡터들이 바로 새로운 축(주성분 방향)이 됩니다.
- 제1주성분 벡터 (\(v_1\)): \(\begin{bmatrix} 0.55 \\ 0.83 \end{bmatrix}\) (자산 A와 B의 변화를 가장 잘 대변하는 대각선 방향의 주된 축)
- 제2주성분 벡터 (\(v_2\)): \(\begin{bmatrix} -0.83 \\ 0.55 \end{bmatrix}\) (그에 직교하는 부차적인 축)
Step 4: 중요도 비교 및 차원 축소 (선택)
구한 고유값(분산의 크기)을 비교합니다.
- 전체 변동성(\(4.38 + 0.21 = 4.59[latex]) 중 제1주성분이 차지하는 비율은 약 95.4%([latex]4.38 / 4.59\))에 달합니다.
- 즉, 굳이 자산 A와 B 두 개의 변수를 다 들고 복잡하게 계산할 필요 없이, 정보의 95% 이상을 담고 있는 제1주성분(\(v_1\)) 하나만 써도 시스템을 완벽히 설명할 수 있다는 결론이 나옵니다. (이것이 바로 차원 축소입니다.)
Step 5: 최종 데이터 변환 (Projection)
원래의 중심화된 데이터 \(X_{centered}\)를 고유벡터 행렬 \(V\) (여기서는 \(v_1\))에 곱해줍니다.
\(Y = X_{centered} \times v_1\)이 행렬곱을 수행하면, 기존의 [자산 A, 자산 B]라는 2차원 좌표계에 있던 데이터들이 “제1주성분 축 위의 1차원 점수(Score)”로 완전히 변환됩니다.
컴퓨터는 이 변환된 1차원 데이터(\(Y\))를 가지고 몬테카를로 시뮬레이션의 난수를 생성하거나, 채권 포트폴리오의 금리 변화 시나리오를 단숨에 계산해내는 것입니다.
2.4. 금리 곡선에서 PCA가 가지는 결정적 의미
리스크 관리에서 PCA는 단순히 수학적 보정 도구를 넘어, 금리 곡선의 변동 원리를 해체하는 핵심 도구로 쓰입니다.
- 채권 만기별 금리(3개월, 1년, 3년, 10년 등)는 서로 끈끈하게 얽혀 있어 콜레스키 분해가 자주 깨집니다.
- 이때 PCA를 적용하면 수십 개의 만기 금리 변동을 단 3개의 주성분(Principal Components)으로 압축할 수 있습니다.
-
- 제1주성분 (Level, 평행 이동): 모든 만기의 금리가 같은 방향으로 오르내리는 현상 (변동성의 약 80~90% 차지)
- 제2주성분 (Slope, 기울기 변화): 단기금리와 장기금리가 서로 반대로 움직여 수익률 곡선이 가파라지거나 완만해지는 현상
- 제3주성분 (Curvature, 곡률 변화): 허리(중기) 금리가 볼록하거나 오목하게 변하는 현상
이처럼 중요도가 떨어지는 미세한 노이즈 차원(고유값이 0에 가까운 것들)을 과감히 버리고 상위 3개의 주성분만 골라내어 몬테카를로 시뮬레이션을 돌리면, 계산 속도가 빨라질 뿐만 아니라 비정상적인 데이터 충돌(콜레스키 실패)을 차단할 수 있어 처음부터 촐레스키 분해는 사용하지 않고 PCA로 사용하기도 하는 방식입니다.